2026 年 9 月 30 日,谷歌发布了一款新的前沿模型:Gemini 4 Argon(氩)。
这两天网上转的都是它的跑分。但把几十篇公开报道从头看到尾之后,我觉得真正该被记住的,不是跑分,而是一个数字——
它的单次输出上限,从 64K 提到了 100 万 token。
这个数字听起来很技术。但它说的其实是一件很朴素的事:AI 一口气能写完的东西,从”一篇长文”变成了”一整本书”。
为什么这件事比跑分重要?往下看。
一,先把这件事说清楚
先交代事实,免得被各种转述带偏。
发布方是 Google DeepMind,时间是 2026 年 9 月 30 日(美国时间),10 月 1 日起各路媒体陆续跟进。
模型代号「氩」(Argon),是元素周期表上的第 18 号元素。谷歌这代模型是按元素周期表命名的——前面有硫、氯,现在轮到氩,后面还有钾、钙。
官方给它的定位,是三件事:长流程软件工程、企业知识工作(法律、金融这类)、网络安全防御。
开放节奏是分阶段的。它不是一上来就对所有人开放:
- 第一阶段:通过 Fairwind Program,只给受信任的网络安全防御者;
- 下一阶段:付费 API 客户和 Google AI Ultra 订阅者;
- 再往后:企业和普通消费者。
官方公布的介绍价是:每百万输入 token 收 2 美元,每百万输出 token 收 10 美元;缓存输入享 95% 折扣。
这里要插一句。Ars Technica 报道称这个模型”API 定价尚未公布”,与谷歌博客公布的介绍价不一致。本文采用官方博客口径,但把这个分歧保留在这里——前沿模型的早期信息,各家说法常有出入,看的时候心里要有数。
二,它的成绩单
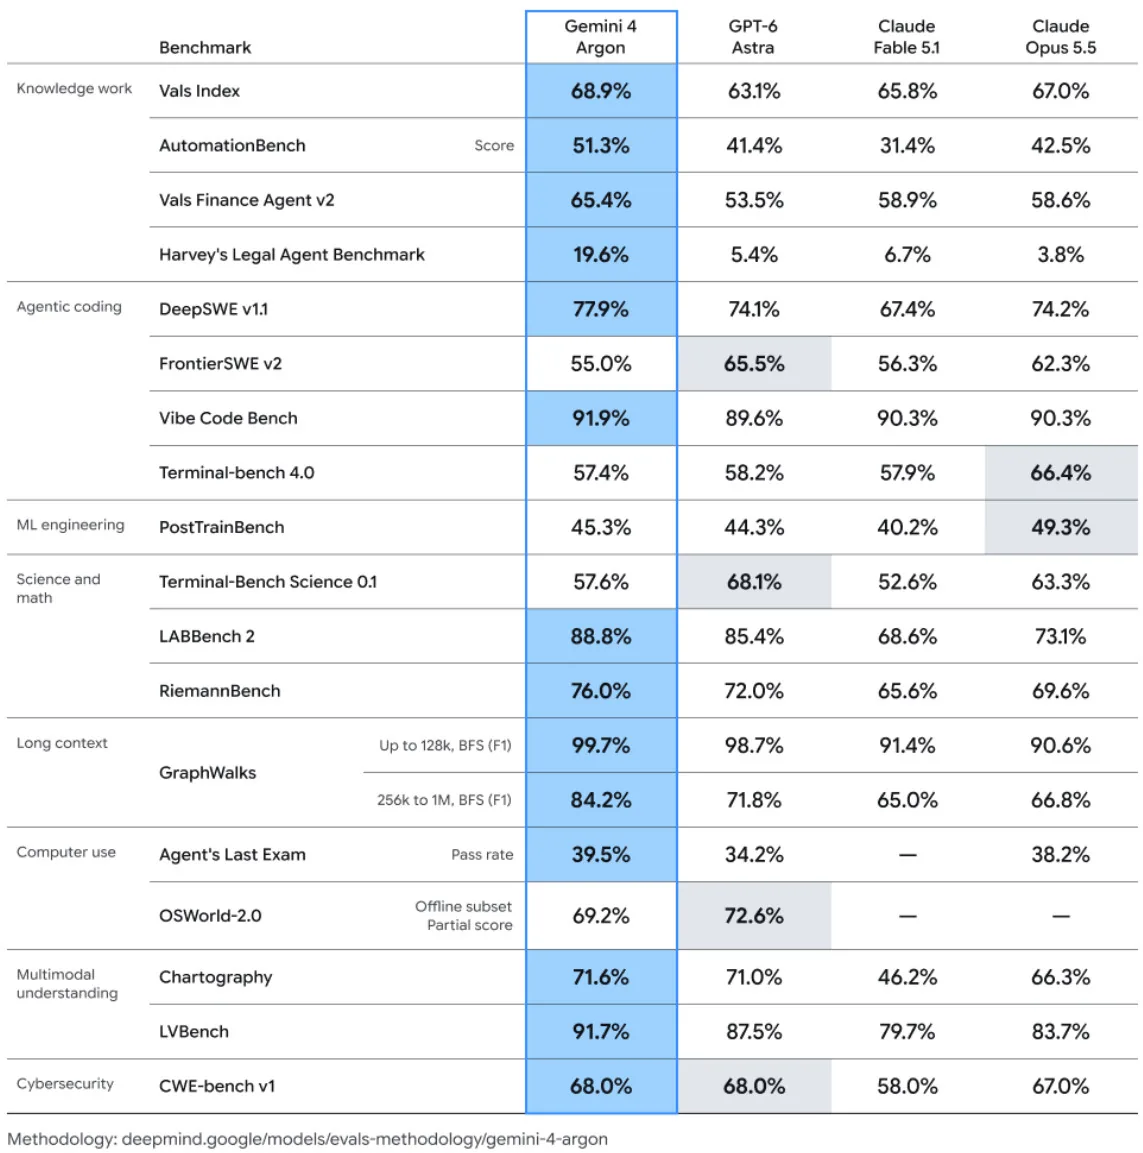
先看官方自己贴出来的那张表——四款前沿模型,18 项基准,逐项对比。
先把第三方评测里最硬的几个数字摆出来:
| 评测 | 成绩 | 说明 |
|---|---|---|
| DeepSWE v1.1 | 77.9% | 软件工程评测,官方称取得新 SOTA |
| Artificial Analysis 智能指数 | 53 | 追平 GPT-6 Astra (max) |
| Text Arena 文本榜 | 1525 分,第 1 名 | 人类盲测投票榜,登顶 |
| AutomationBench-AA | 77.5%,第 1 名 | 智能体任务,历来是 Gemini 的弱项 |
| 幻觉率(AA-Omniscience) | 15% | 45 分以上模型里最低(GPT-6 Astra 51%、GPT-6.1 Sol 54%) |
| Harvey 法律智能体基准 | 19.6% | 官方选定对手中领先;但公开榜排第 5/73,前四为 Meta Muse Spark |
| 单次输出上限 | 100 万 token | 此前为 64K |
| 每任务成本 | $1.99 | 约为 GPT-6 Astra 的 60%;但为 GPT-6.1 Sol 的 2.7 倍(AA 口径) |
官方那张表里,18 项基准,Argon 拿下大半数第一。但我不建议你一行行去比——更值得看的,是「长上下文」(Long context)那一栏。
这一栏测的是 GraphWalks:在 25 万到 100 万 token 的输入里,模型能不能顺着关系链条把答案找出来。Argon 在 128k 以内拿 99.7%,在 256k 到 1M 这一档拿 84.2%;而第二名的 GPT-6 Astra,同档只有 71.8%。差了 12 个百分点。
换句话说,”100 万 token”对 Argon 不是一个宣传数字,是在这个长度上实测还能站得住。这跟前面说的输出上限,是一件事的两面。
当然也有几项它没赢:FrontierSWE v2 输给 GPT-6 Astra(55.0% 对 65.5%),Terminal-bench 4.0 输给 Claude Opus 5.5(57.4% 对 66.4%),OSWorld-2.0 也落后(69.2% 对 72.6%)。这些落项,恰恰说明它强,但没有通吃。
读这张表,先给一个诀窍:成本那一栏,换个对手,结论能完全反过来。
按 AA 的每任务成本算,Argon 花 $1.99,是 GPT-6 Astra($3.26)的六成——看着便宜。可换成 GPT-6.1 Sol,Sol 只要 $0.72,Argon 一下子变成它的 2.7 倍。
单价明明一样(都是 $2 输入/$10 输出),账单却翻倍,原因只有一个:它话多。Argon 平均每个任务要吐 6.2 万 token,Astra 只用 2.7 万。写得长,单价再低也扛不住。所以往后看到”成本降低 X%”这种话,先问一句:跟谁比、按什么口径算。
还有一处不对等值得记一笔:Argon 这份成绩单是用 high 推理档跑的,而 Astra 和 Sol 用的是 max 档。同一张表上的数字,未必是在同一个档位上测出来的。
还有一处要交代。名字看着一样的评测,官方和第三方常常对不上。比如 AutomationBench,谷歌官方报 51.3%,Artificial Analysis 的 AutomationBench-AA 报 77.5%——不是谁造假,是评测集版本、给分规则、跑法都不一样。看跑分这件事,本身就带着口径的坑。
看这张表,你会得出一个结论:它很强,但没到”碾压”。
智能指数 53 分是”追平”,不是”超过”;成本低是好事,但那是厂商打仗,跟你关系不大。真正跟你有关的,是表里最后那行——输出上限。
三,真正的大事,是那 100 万 token
先说清楚 token 是什么。你可以把它理解成 AI 的”计件单位”——它读和写,都按 token 算。一个 token 大约相当于半个到一个汉字。
64K token,大约四五万汉字。这是以前很多模型的输出上限。什么概念?大概是一篇长篇报告,或者一份中等规模的代码文件。
100 万 token,大约六十到七十万汉字。什么概念?大概是一本长篇小说的体量,或者一整个中小型项目的全部代码。
差别在哪?记住这一句就够了:
输入长度,决定 AI 能”读”多少;输出长度,决定 AI 能”干”多少。
这两件事经常被混为一谈。上下文窗口大,是说它能一口气读懂你丢过来的一整柜资料;输出上限大,是说它能一口气交给你一整套成品。
过去输出卡在 64K,意味着不管你给的任务多复杂,它最后只能给你”一小段”。你想让它做完一个项目,就得切成十几段,一段一段来,中间还得你盯着衔接、帮着擦屁股。
现在输出到 100 万,等于把一个任务从头到尾交给它,它一次给你完整成品。
顺带说一句,它的输入上下文窗口也是 100 万 token。也就是说,”读”和”写”两头都拉到了百万级——你丢给它一整柜资料,它还你一整套成品。
还有一个工程细节值得记一笔。为了撑住这么长的输出,谷歌加了个叫 Long Decode Continuation 的机制:长回答可以中途暂停,下次调用接着写,不会因为请求超时而断掉。翻成大白话——它学会了”分几次呼吸,但记性不断”。
这就是谷歌反复提的”长程任务”——不是单点聪明,是能扛住一整条长链,中途不跑偏、不忘事。
有位评测者的说法很准:长输出空间,让模型能在”单次轨迹”里完成深度推理。翻成大白话就是——它不用再”分次呼吸”,可以一口到底。
四,也有争议,得说清楚
书院的老规矩,报喜也报忧。
彭博社的报道提到,有知情人士称 Argon 部分代码任务表现不佳,尤其不擅长前端设计。谷歌否认了这一说法,DeepMind 负责人表示”对性能感到鼓舞”。
The Decoder 的评价更直接:Argon 是谷歌七个多月来的首款前沿模型,缩小了与 OpenAI、Anthropic 的差距,但没有明显领先。
Artificial Analysis 还提醒,那个 50% 折扣是”初始促销价”,结束日期未确认。
所以我的判断是:这是一款很强、但远没到”碾压”的模型。它把谷歌重新拉回了第一梯队,但还没把对手甩开。
对普通用户的现实意义是:现在还轮不到你我上手——先给网络安全防御者和付费客户,而且早期表现仍有争议。
那为什么还值得写这一篇?因为那个数字代表的方向,跟每个人都有关系。
五,那这跟你有什么关系
书院一直在讲一件事:AI 伙伴和 AI 工具,是两回事。
工具是你问一句,它答一句。伙伴是你给一个目标,它给你一个结果。
而”输出上限翻 16 倍”这件事,恰恰就是”工具→伙伴”这条路上,最关键的一块拼图。
为什么?因为当 AI 一次只能输出一小段时,它注定只能当工具——你必须不停喂它下一步、盯它衔接、替它收尾。到头来,真正干活的还是你。
只有当它能一口气输出一整套时,你才有可能只做一件事:把目标说清楚。
对一人公司、对内容创作者、对任何一个想”用一个人的产能干一个团队的活”的人来说,这是根本性的变化。
但也要泼一盆冷水:模型越强,越考验你”给对目标”的能力。
一个能一次输出百万 token 的模型,交到糊涂人手里,只会更快地产出一堆更长的垃圾。真正稀缺的从来不是产能,是判断力——知道要什么、知道什么算好。
这也是书院这段时间一直在做的功课:不追最新模型,而是把”怎么给对目标、怎么验收结果”这套东西,一点一点磨出来。
六,最后说一句真话
每年都会有好几款”最强模型”发布。跑分会一直被刷新,排名会一直变。
但有一条线是确定的:AI 一次能干完的事,在肉眼可见地变长。
从一句,到一段,到一篇,到现在的一整本。
所以别太在意这一款模型的排名。更值得你花时间想的,是这个问题:
当 AI 能一口气交给你一整件事的时候,你准备让它去干哪一件?
我是 AI 点化师桥山长,让你的 AI 有心跳,讲真话。